Los modelos más baratos y la trampa de los contadores de tokens
Más tokens para el mismo texto, cambios de tarifa y cuotas difíciles de interpretar: qué hay detrás del precio de Haiku 5.5 y GPT-6 Luna.
Los nuevos modelos anuncian precios más bajos por millón de tokens. Pero, si el mismo texto empieza a ocupar más tokens, la comparación también depende de una unidad que ha cambiado de tamaño. El recuento sube aunque nosotros enviemos lo mismo.
Con Haiku 5.5, el aumento está documentado: aproximadamente un 30% más que con Haiku 4.5 para el mismo texto. A esto se suman tarifas que saltan al superar un umbral, categorías que el contador visible deja fuera y porcentajes de cuota que no explican su relación con ese número.
Ese es el problema de fondo. Una tarifa pequeña no basta para entender una cuenta que el usuario no puede reconstruir. Si se anuncia el descuento por token, también se debería enseñar cuánto ha crecido el recuento para la misma información.
Haiku: entre el 25% observado y el 30% documentado
El tokenizador divide el contenido en las unidades que utiliza el modelo. Al cambiarlo, una frase puede seguir siendo la misma y ocupar más tokens. La guía de migración de Haiku 5.5 sitúa el aumento del texto alrededor del 30%, con variaciones según el contenido.
Hay una comprobación independiente. Simon Willison publicó el 7 de octubre una prueba con un prompt largo que daba aproximadamente 1,25 veces el recuento anterior: un 25% más. Es una sola prueba, no una media de todos los usos.
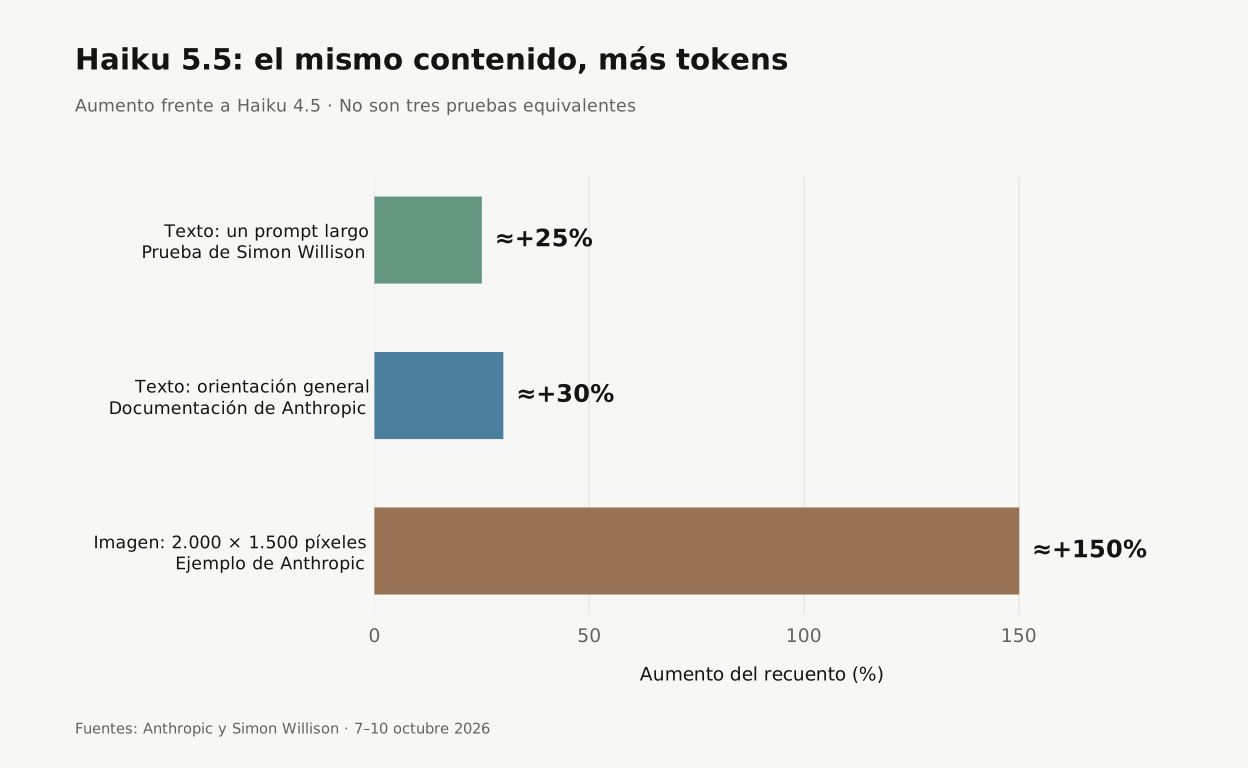
El ejemplo visual de Anthropic cuesta unas 2,5 veces los tokens de Haiku 4.5: eso es un 150% más, no un 250% más. El modelo conserva más resolución. Hay más consumo, pero también cambia lo que procesa.
Con el texto, la consecuencia práctica se ve enseguida: si aplicamos aquel 30% como aproximación, 100.000 tokens antiguos pasan a 130.000. Y un presupuesto fijo de 100.000 tokens contiene un 23,1% menos de texto, porque 100/130 es aproximadamente 0,769. Este cálculo mantiene el mismo presupuesto; no compara el tamaño real de las ventanas de contexto de ambos modelos.
Cuando el coste llega a 6,5 veces el presupuesto
La tarifa Standard de entrada de Haiku 5.5 anuncia 0,10 dólares por millón hasta 100.000 tokens. Por encima, cobra 0,50 por millón para toda la petición. Esa combinación multiplica el efecto del recuento nuevo. Tarifas y umbral de Haiku.
Imaginemos que calculamos el presupuesto con el recuento de Haiku 4.5 y la tarifa corta de Haiku 5.5. Es un cálculo hipotético, solo de entrada, sin caché, salida ni herramientas. Para un texto de 50.000 tokens, esperaríamos pagar 0,005 dólares. Si ahora ocupa 65.000, el coste es 0,0065: un 30% más de lo presupuestado.
Con un texto de 80.000 tokens, la cuenta inicial sería de 0,008 dólares. Aplicando aquel aumento del 30%, pasa a 104.000 y cruza el umbral. El coste de entrada llega a 0,052: 6,5 veces la estimación, un 550% más. La referencia es el presupuesto calculado con el recuento antiguo y la tarifa corta del modelo nuevo, no la factura del modelo anterior.
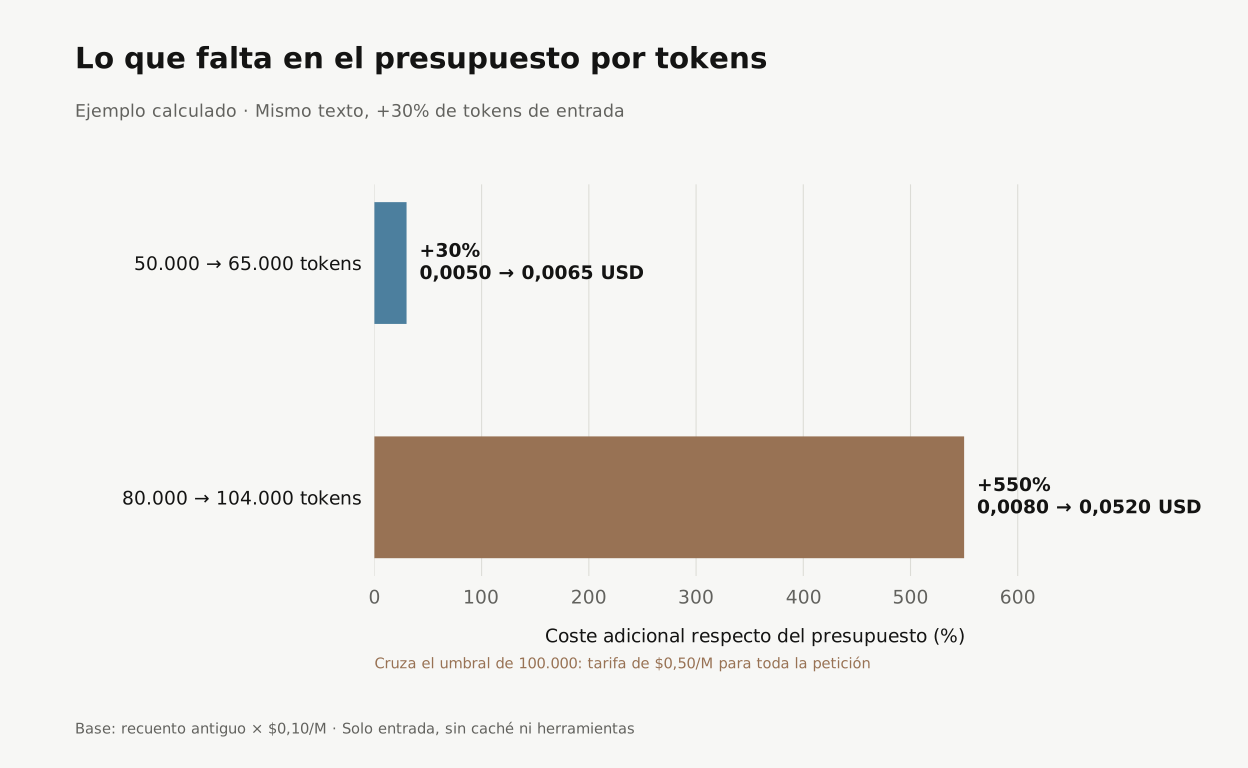
El precio anunciado invita a hacer una multiplicación sencilla. Lo que falta a la vista es que pueden cambiar a la vez las unidades contadas y el precio que se les aplica. En el segundo ejemplo, subestimar el recuento también hace elegir la tarifa equivocada.
Luna tiene sus propias condiciones: al superar 272.000 tokens de entrada, duplica la tarifa de entrada y multiplica la de salida por 1,5 para toda la petición. Por eso, para interpretar el contador, hace falta conocer la tarifa efectiva además del precio de la primera fila.
Por qué el porcentaje de la cuota puede avanzar más que el contador
Aquí aparece otra confusión. Un porcentaje necesita un denominador. En Claude Code, la ocupación del contexto se calcula con entrada y caché respecto de la ventana del modelo. Los porcentajes de los límites de cinco horas y siete días son campos distintos. Un 30% más de tokens de texto no implica automáticamente un 30% más de cuota gastada.
Una medición de Inventive HQ, del 2 al 4 de octubre, permite ver la distancia. En una cuenta Pro con varios modelos, el contador final acumulaba aproximadamente 30,3 millones de tokens sin las lecturas de caché. Al incluirlas, las categorías publicadas suman unos 697,4 millones: aproximadamente 23 veces el recuento. Esa actividad correspondía a un 33% de la cuota semanal.
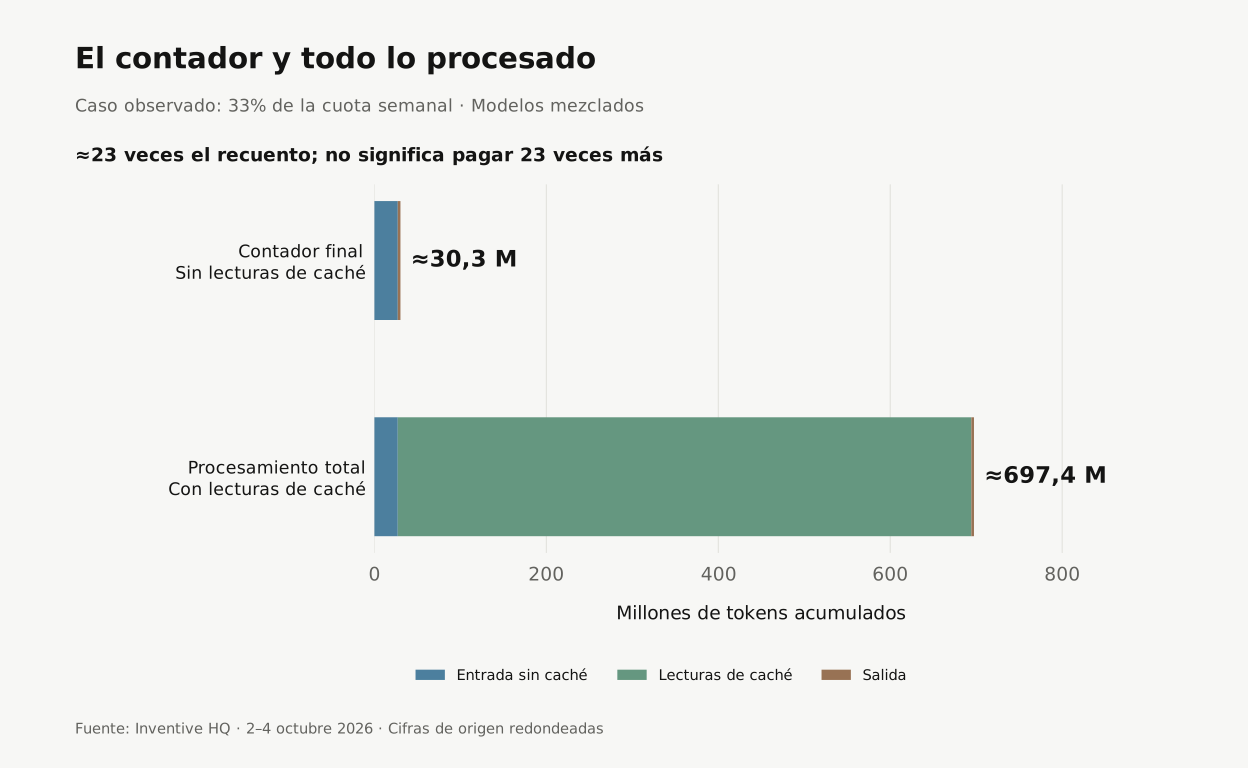
Las lecturas de caché cuestan menos. Por eso procesar 23 veces más tokens que los mostrados no equivale a pagar 23 veces más. El autor estimó unos 214 dólares a tarifas de API para ese consumo; no fue una factura adicional de su suscripción. Tampoco estableció una conversión universal entre tokens y porcentaje, y dejó sin resolver el peso específico de Luna en la cuota.
En Luna, un millón de tokens de salida pesa cinco veces más
Un total de tokens tampoco explica por sí solo el consumo de créditos. Los precios de Codex asignan a Luna 2,5 créditos por millón de entrada Standard, 0,25 de entrada en caché y 12,5 de salida. El mismo número de tokens pesa cinco veces más si es salida en vez de entrada sin caché.
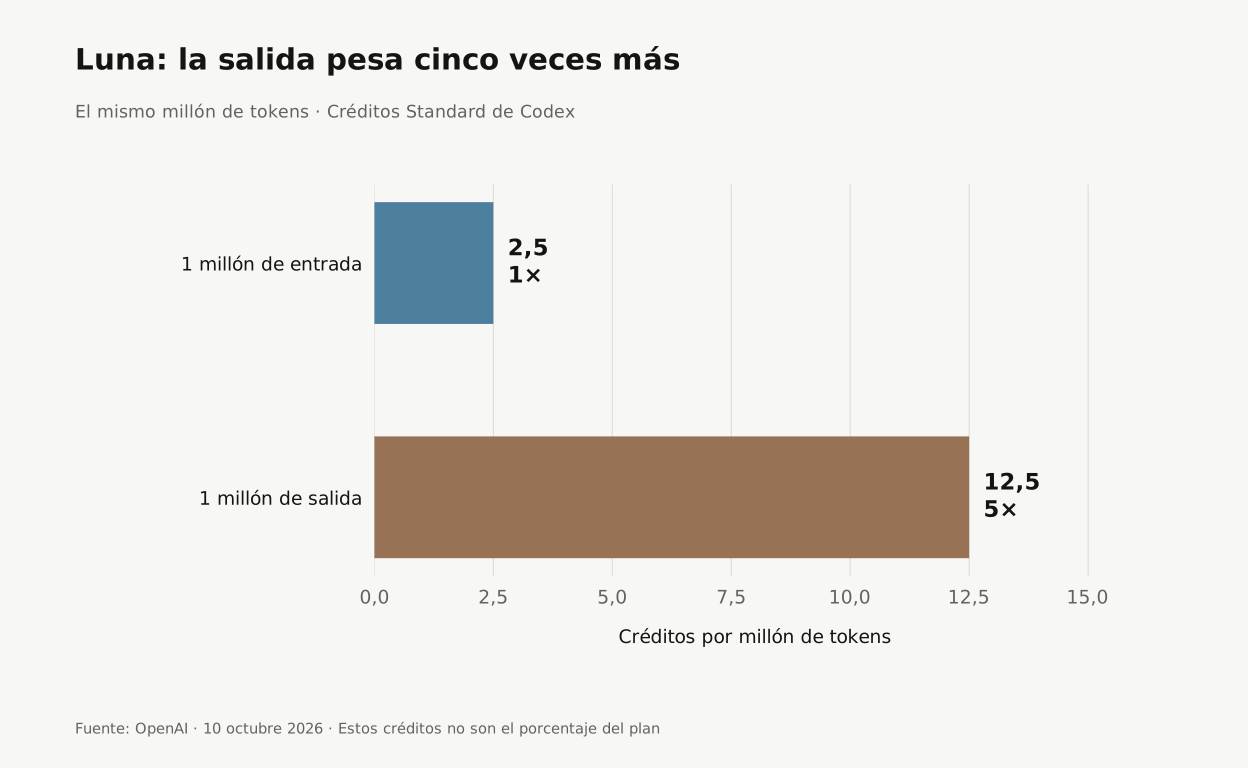
Un contador que agrupa entrada y salida en un solo número no permite ver esa diferencia. Si la barra de cuota tampoco explica sus ponderaciones, cuesta más interpretar el consumo. El usuario ve avanzar el porcentaje sin una cuenta completa con la que comprobarlo.
Lo que el contador todavía puede dejar fuera
También importa qué sesiones suma. Una prueba de Luna con Codex 0.155.1 verificó contadores independientes por agente. El coste equivalente de API del agente principal era 2,67 dólares; con sus cuatro subagentes, 5,62: un 110,5% más de coste estimado al incluir todo el equipo. No es un aumento de tokens por tokenizador ni una factura real, y depende de aquella versión.
La salida incluye el razonamiento interno, aunque la respuesta visible sea breve; no hay que sumarlo de nuevo. Con la compactación de Claude en el servidor, en beta, los totales principales excluyen la iteración que resume el contexto. Para recoger todo el consumo hay que sumar usage.iterations.
El 30% adicional de Haiku está documentado para el mismo texto. Los casos de Codex muestran otros problemas de contabilidad y ponderación. Cada uno merece una explicación completa de lo que se cobra o descuenta, manteniendo claras sus distintas causas.
Yo pediría tres cosas: un recuento comparable para el mismo contenido, todas las categorías de consumo a la vista y una explicación de cómo ese consumo mueve la cuota. Si el proveedor cambia la unidad o la manera de ponderarla, esa diferencia debería aparecer junto al precio anunciado.
La trampa está en anunciar la bajada del precio por token sin dejar igual de claro que el mismo trabajo consume más unidades o pesa más de lo que sugiere el contador. El descuento resulta fácil de ver. Comprobar el coste completo exige más trabajo al usuario.
Fuentes comprobadas el 10 de octubre de 2026. La fotografía de portada es una imagen conceptual generada con IA; no muestra una factura real.