Jev y Laya: ahorrar en decisiones sin perder de vista el proyecto
Jev y Laya pueden abaratar decisiones concretas. Elegir un modelo de Claude para programar exige conocer el proyecto y lo que cambia durante el trabajo.
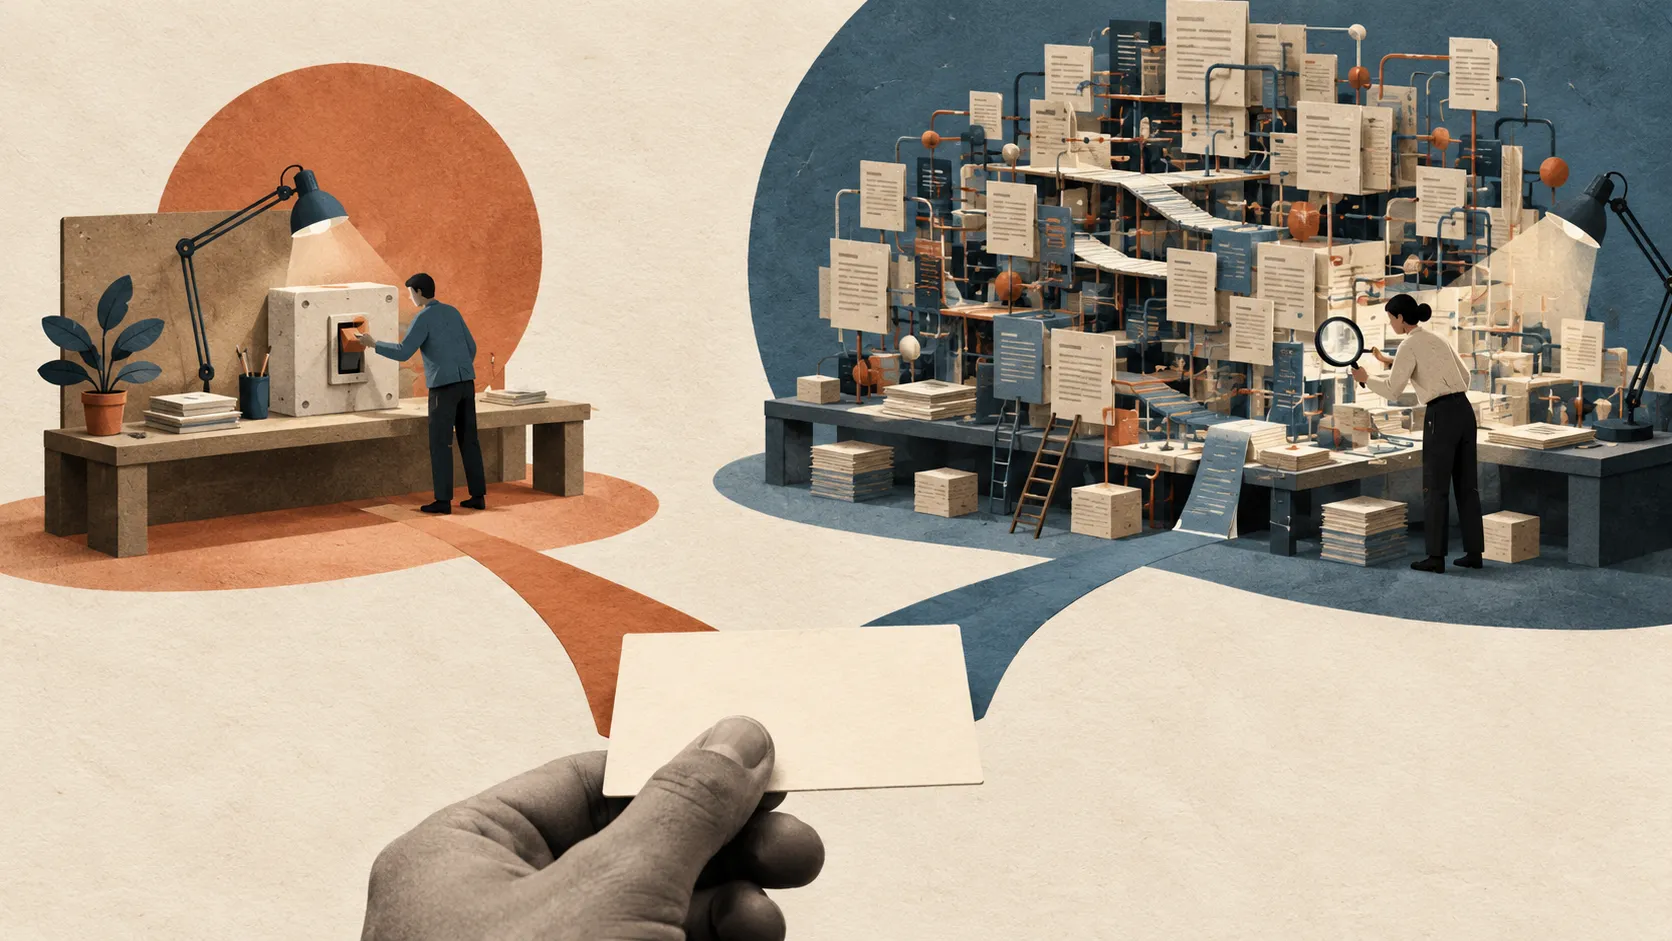
«Cambia el idioma del proyecto».
En una aplicación basta con tocar una línea de configuración. En otra hay que localizar miles de textos, incorporar un sistema de traducciones, adaptar las pantallas y volver a comprobarlo todo. Y si el usuario se refiere al lenguaje de programación, quizá esté pidiendo una migración.
Una línea o 3.000: una petición igual de breve puede esconder trabajos muy distintos. Son ejemplos hipotéticos; contar líneas tampoco sirve para medir la dificultad. Lo que sí muestran es que la petición, por sí sola, no nos dice qué necesita el proyecto.
Ahí pondría el límite de los modelos de decisión baratos. Jev y Laya pueden ayudarnos a gastar menos en las pequeñas decisiones que toma una aplicación. Elegir qué modelo de Claude debe hacerse cargo de una tarea de programación exige conocer bastante mejor el trabajo que hay detrás.
Dónde merece la pena usarlos
Jev recibe información y devuelve opciones, puntuaciones o probabilidades de respuesta afirmativa. Su documentación aconseja hacer preguntas concretas y combinar las respuestas mediante código. Laya ofrece decisiones estructuradas similares. Introducción a Jev, Ficha de Laya
Pensemos en un sistema de atención al cliente que consulta una y otra vez a un modelo caro para saber si un mensaje trata de facturación o si el cliente está molesto. Una capa de decisión más económica podría encargarse de esas preguntas, siempre que comprobemos cómo responde con mensajes reales.
| Decisión | Información necesaria | Qué podríamos ahorrar |
|---|---|---|
| Detectar la intención o el tono | El mensaje y los intercambios anteriores que importen | Una llamada de clasificación a un modelo mayor |
| Decidir si hay que consultar documentos internos | La petición y una descripción de las fuentes disponibles | Búsquedas innecesarias |
| Elegir una herramienta conocida | La petición, las herramientas candidatas y los identificadores necesarios | Parte del trabajo de selección |
| Filtrar fragmentos recuperados con RAG | La pregunta y los fragmentos encontrados | Texto enviado al modelo que redacta la respuesta |
| Elegir un modelo de ejecución | Datos sobre la tarea y resultados medidos de cada modelo | Llamadas caras en los casos que otro modelo resuelva bien |
Son usos que merece la pena evaluar, no garantías de rendimiento. RAG consiste en recuperar información relevante antes de responder. Además, una petición puede necesitar documentos y herramientas a la vez: «consulta mi pedido y explícame la política de devoluciones».
TypeSafe publica ejemplos de filtrado de documentos y selección de funciones cuyos argumentos proceden de listas cerradas. Filtrado para RAG, Selección de funciones
Después de elegir la función, la aplicación todavía tiene que validar los datos, comprobar los permisos, ejecutarla y gestionar los errores. Redactar una consulta libre o llevar a cabo una migración requiere pasos adicionales.
Saber qué pide el usuario no basta para saber cuánto cuesta hacerlo
Un clasificador puede reconocer perfectamente que cambiar el idioma es una tarea de software. Para elegir qué modelo de Claude debería resolverla, quizá haya que revisar el repositorio: traducciones existentes, dependencias, pruebas, condiciones de despliegue y decisiones anteriores.
Con «arregla la autenticación» ocurre lo mismo. Puede faltar un ajuste, o puede haber un problema que afecte a sesiones, permisos y almacenamiento. Sin examinarlo, cualquier etiqueta de dificultad se basa en información incompleta.
Y esa información cambia mientras trabajamos. Una prueba falla y deja al descubierto otra dependencia. Una herramienta devuelve algo inesperado. Un cambio que parecía aislado afecta a otro servicio. La decisión tomada a partir de la primera frase no puede tener en cuenta lo que aún no se ha descubierto.
Sí pueden leer contexto; lo difícil es darles el que necesitan
Decir que Jev y Laya no admiten contexto sería incorrecto. Jev 1.13 acepta 64.000 tokens por petición, con un límite adicional de 32.000 para el estado y la pregunta más larga. Laya parte de 512 en su versión inglesa; la multilingüe usa 1.024 por defecto y admite hasta 8.192. Límites de Jev, Límites de Laya
Que el texto quepa no garantiza que el modelo lo interprete bien. TypeSafe reconoce dificultades al encadenar razonamientos y al recibir información irrelevante. Laya documenta errores con alta confianza y recomienda comprobar sus probabilidades con datos propios. Limitaciones de Jev, Limitaciones de Laya
«Haz lo mismo con la otra cuenta» depende de lo ocurrido antes. Hay que saber qué operación se hizo, de qué cuenta hablamos y si el intento anterior salió bien. Un resumen puede conservar esos datos, pero también dejárselos o quedarse desactualizado. Preparar y mantener esa información tiene un coste que debemos contar.
Darle una responsabilidad concreta y revisar la decisión cuando haga falta
Mi propuesta es usar código para las reglas exactas, un modelo de decisión para las clasificaciones que exigen interpretar el mensaje y un agente de programación para investigar e implementar.
Si la dificultad depende del repositorio, primero hay que examinarlo. Después podemos elegir el modelo con lo aprendido, dejar una salida para los casos dudosos y cambiar de modelo si aparecen nuevos problemas. Los umbrales de confianza deben ajustarse a errores observados; la falta de contexto y las peticiones desconocidas necesitan sus propias comprobaciones.
Esto puede ayudar a distribuir trabajo dentro de un flujo con Claude. Por sí solo, no convierte a Jev o Laya en un selector todoterreno fiable. Su utilidad depende de la información que reciben y de las decisiones que hayamos comprobado que saben tomar.
El ahorro se mide al terminar el trabajo
Supongamos que una clasificación cuesta 0,002 dólares. La alternativa cuesta 0,00002, pero en el 20% de los casos aún necesitamos la llamada original. El promedio queda en 0,00042: un ahorro del 79% en esa etapa, antes de contar los errores. Son cifras inventadas para explicar el cálculo, no tarifas ni resultados medidos.
Si esa clasificación representa solo el 5% de la factura, el ahorro total sería de aproximadamente el 3,95%, manteniendo igual el resto. Para ahorrar más, habría que evitar trabajo caro posterior o reducir el texto que recibe el modelo.
En la fecha de publicación, Jev anuncia 0,042 dólares por millón de tokens de entrada y no cobra la salida. Alojar Laya por nuestra cuenta también cuesta: hay que pagar recursos y mantener el servicio. Precio de Jev
Lo que interesa medir es el coste de cada tarea resuelta correctamente, incluida la investigación, los reintentos y los cambios de modelo. Una decisión barata que sale mal puede acabar en una recuperación cara.
Yo empezaría por intención, tono, relevancia de documentos y procesos conocidos. Para un agente de programación, mantendría la selección de modelo abierta a lo que vaya descubriendo del proyecto. Una petición corta puede acabar en una línea o en una migración considerable. Antes de comprometerse, el sistema necesita saber qué trabajo está aceptando.