Jev i Laya: estalviar en decisions sense perdre de vista el projecte
Jev i Laya poden abaratir decisions concretes. Triar un model de Claude per programar demana conèixer el projecte i què canvia mentre hi treballem.
«Canvia l’idioma del projecte».
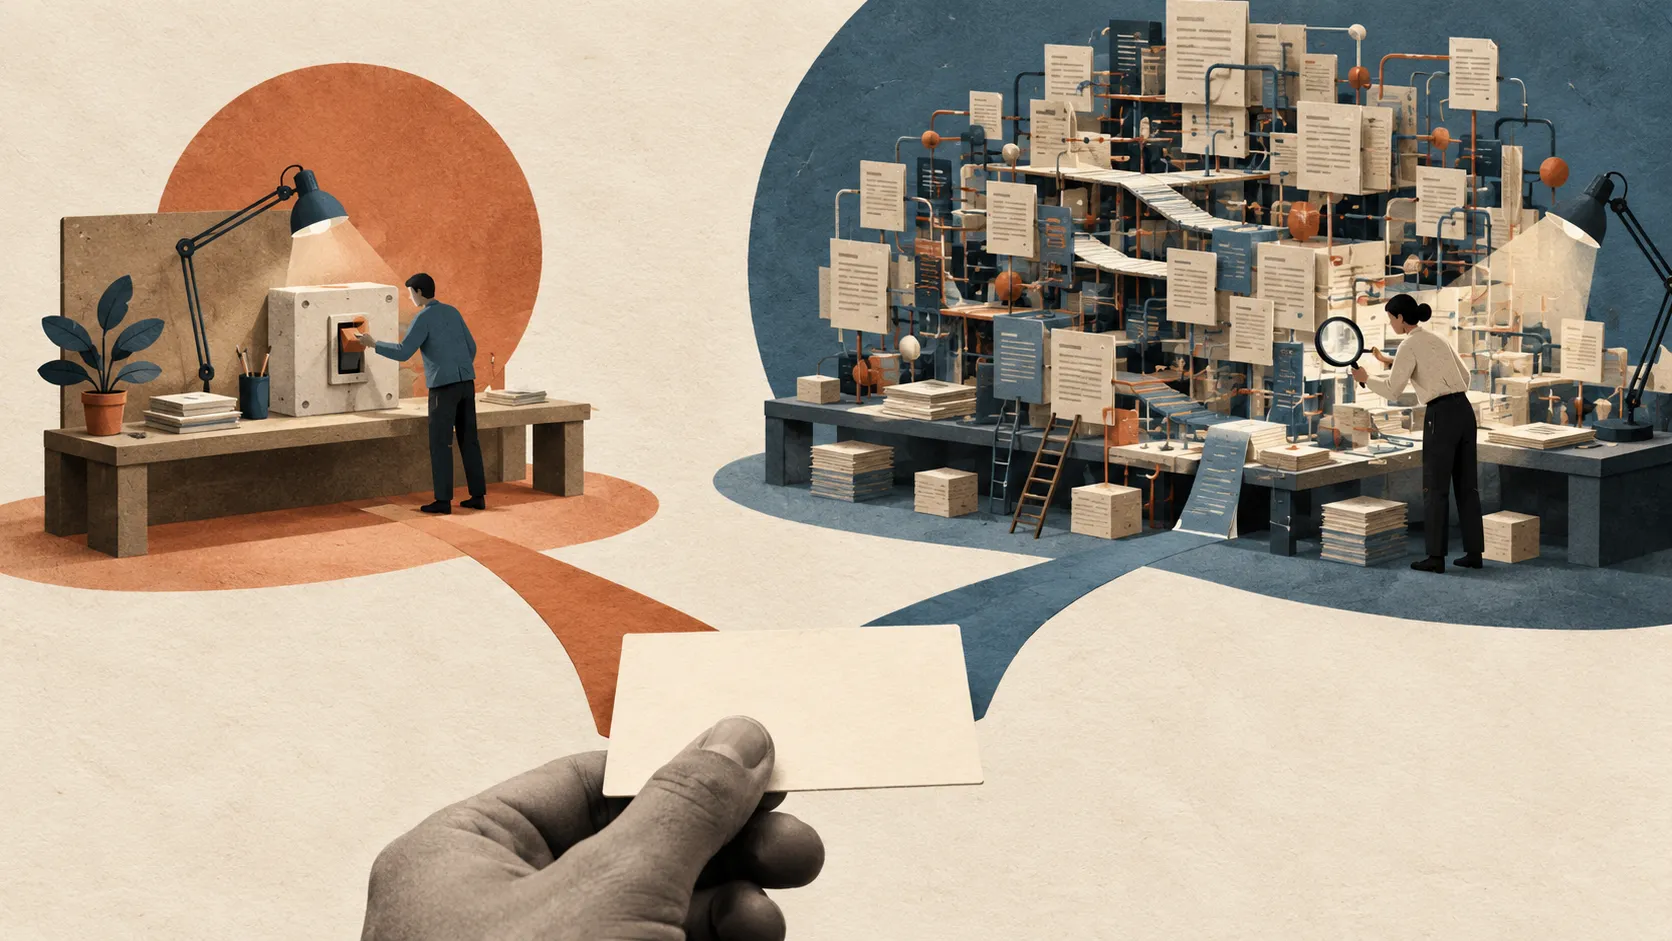
En una aplicació n’hi ha prou de tocar una línia de configuració. En una altra cal trobar milers de textos, incorporar un sistema de traduccions, adaptar les pantalles i tornar-ho a comprovar tot. I si l’usuari es refereix al llenguatge de programació, potser ens està demanant una migració.
Una línia o 3.000: una petició igual de curta pot amagar feines molt diferents. Són exemples hipotètics; comptar línies tampoc no ens diu si una tasca és difícil. El que sí que mostren és que la petició, tota sola, no ens explica què necessita el projecte.
Aquí és on posaria el límit dels models de decisió econòmics. Jev i Laya ens poden ajudar a gastar menys en les petites decisions d’una aplicació. Triar quin model de Claude s’ha d’encarregar d’una tasca de programació demana conèixer força millor la feina que hi ha al darrere.
On val la pena fer-los servir
Jev rep informació i retorna opcions, puntuacions o probabilitats de resposta afirmativa. La documentació recomana fer preguntes concretes i combinar-ne les respostes amb codi. Laya ofereix decisions estructurades semblants. Introducció a Jev, Fitxa de Laya
Pensem en un servei d’atenció al client que consulta repetidament un model car per saber si un missatge tracta de facturació o si el client està empipat. Una capa de decisió més econòmica podria respondre aquestes preguntes, sempre que en comprovem els resultats amb missatges reals.
| Decisió | Informació que cal | Què ens podríem estalviar |
|---|---|---|
| Detectar la intenció o el to | El missatge i les converses anteriors que siguin rellevants | Una crida de classificació a un model més gran |
| Decidir si cal consultar documents interns | La petició i una descripció de les fonts disponibles | Cerques innecessàries |
| Triar una eina coneguda | La petició, les eines candidates i els identificadors necessaris | Part de la feina de selecció |
| Filtrar fragments recuperats amb RAG | La pregunta i els fragments trobats | Text enviat al model que redacta la resposta |
| Triar el model que farà la feina | Dades de la tasca i resultats mesurats de cada model | Crides cares en casos que un altre model resolgui bé |
Són usos que val la pena avaluar, no garanties de rendiment. RAG consisteix a recuperar informació rellevant abans de respondre. Una petició també pot necessitar documents i eines alhora: «consulta la meva comanda i explica’m la política de devolucions».
TypeSafe publica exemples de filtratge de documents i de selecció de funcions amb arguments que provenen de llistes tancades. Filtratge per a RAG, Selecció de funcions
Un cop triada la funció, l’aplicació encara ha de validar les dades, comprovar els permisos, executar-la i gestionar els errors. Redactar una consulta lliure o dur a terme una migració requereix més passos.
Entendre la petició no és suficient per saber quanta feina hi ha
Un classificador pot reconèixer perfectament que canviar l’idioma és una tasca de programari. Per triar quin model de Claude l’hauria de resoldre, potser cal revisar el repositori: traduccions existents, dependències, proves, condicions de desplegament i decisions anteriors.
Amb «arregla l’autenticació» passa el mateix. Pot faltar un ajust, o pot haver-hi un problema que afecti les sessions, els permisos i l’emmagatzematge. Sense examinar-ho, qualsevol estimació de la dificultat es basa en informació incompleta.
I aquesta informació canvia a mesura que treballem. Una prova falla i posa al descobert una altra dependència. Una eina retorna un resultat inesperat. Un canvi que semblava aïllat afecta un altre servei. La decisió presa amb la primera frase no pot tenir en compte allò que encara no s’ha descobert.
Sí que poden llegir context; el repte és donar-los el que cal
Dir que Jev i Laya no admeten context seria incorrecte. Jev 1.13 accepta 64.000 tokens per petició, amb un límit addicional de 32.000 per a l’estat i la pregunta més llarga. Laya parteix de 512 en la versió anglesa; la multilingüe en fa servir 1.024 per defecte i n’admet fins a 8.192. Límits de Jev, Límits de Laya
Que el text hi càpiga no garanteix que el model l’interpreti bé. TypeSafe reconeix dificultats quan cal encadenar raonaments o quan hi ha informació irrellevant. Laya documenta errors amb una confiança alta i recomana comprovar les probabilitats amb dades pròpies. Limitacions de Jev, Limitacions de Laya
«Fes el mateix amb l’altre compte» depèn del que ha passat abans. Cal saber quina operació s’ha fet, de quin compte parlem i si l’intent anterior ha anat bé. Un resum pot conservar aquestes dades, però també se les pot deixar o quedar desactualitzat. Preparar i mantenir aquesta informació té un cost que hem de comptar.
Donar-los una responsabilitat concreta i revisar la decisió quan calgui
Proposo fer servir codi per a les regles exactes, un model de decisió per a les classificacions que demanen interpretar el missatge i un agent de programació per investigar i implementar.
Si la dificultat depèn del repositori, primer cal examinar-lo. Després podem triar el model amb el que hem après, deixar una sortida per als casos dubtosos i canviar de model si apareixen problemes nous. Els llindars de confiança s’han d’ajustar segons els errors observats; la manca de context i les peticions desconegudes necessiten comprovacions específiques.
Això pot ajudar a repartir la feina dins d’un procés amb Claude. Tot sol, no converteix Jev o Laya en un selector universal fiable. La seva utilitat depèn de la informació que reben i de les decisions que hàgim comprovat que saben prendre.
L’estalvi es mesura quan la feina està feta
Suposem que una classificació costa 0,002 dòlars. L’alternativa en costa 0,00002, però en el 20% dels casos encara cal fer la crida original. El cost mitjà queda en 0,00042: un estalvi del 79% en aquella etapa, abans de comptar els errors. Són xifres inventades per explicar el càlcul, no tarifes ni resultats mesurats.
Si la classificació representa només el 5% de la factura, l’estalvi total seria d’aproximadament el 3,95%, mantenint igual tota la resta. Per estalviar més, caldria evitar feina cara posterior o reduir el text que rep el model.
En la data de publicació, Jev anuncia 0,042 dòlars per milió de tokens d’entrada i no cobra la sortida. Allotjar Laya pel nostre compte també té un cost: cal pagar recursos i mantenir el servei. Preu de Jev
Ens interessa mesurar el cost de cada tasca resolta correctament, incloent-hi la investigació, els reintents i els canvis de model. Una decisió barata que surt malament pot acabar exigint una recuperació cara.
Jo començaria per la intenció, el to, la rellevància dels documents i els processos coneguts. Per a un agent de programació, mantindria la tria de model oberta al que vagi descobrint del projecte. Una petició curta pot acabar en una línia o en una migració considerable. Abans de comprometre-s’hi, el sistema necessita saber quina feina està acceptant.