Jev و Laya: تصمیم ارزان، با شناخت درست از پروژه
Jev و Laya هزینهٔ تصمیمهای محدود را کاهش میدهند. انتخاب مدل Claude برای برنامهنویسی به شناخت مرتبط و بهروز از پروژه نیاز دارد.
«زبان پروژه را عوض کن.»
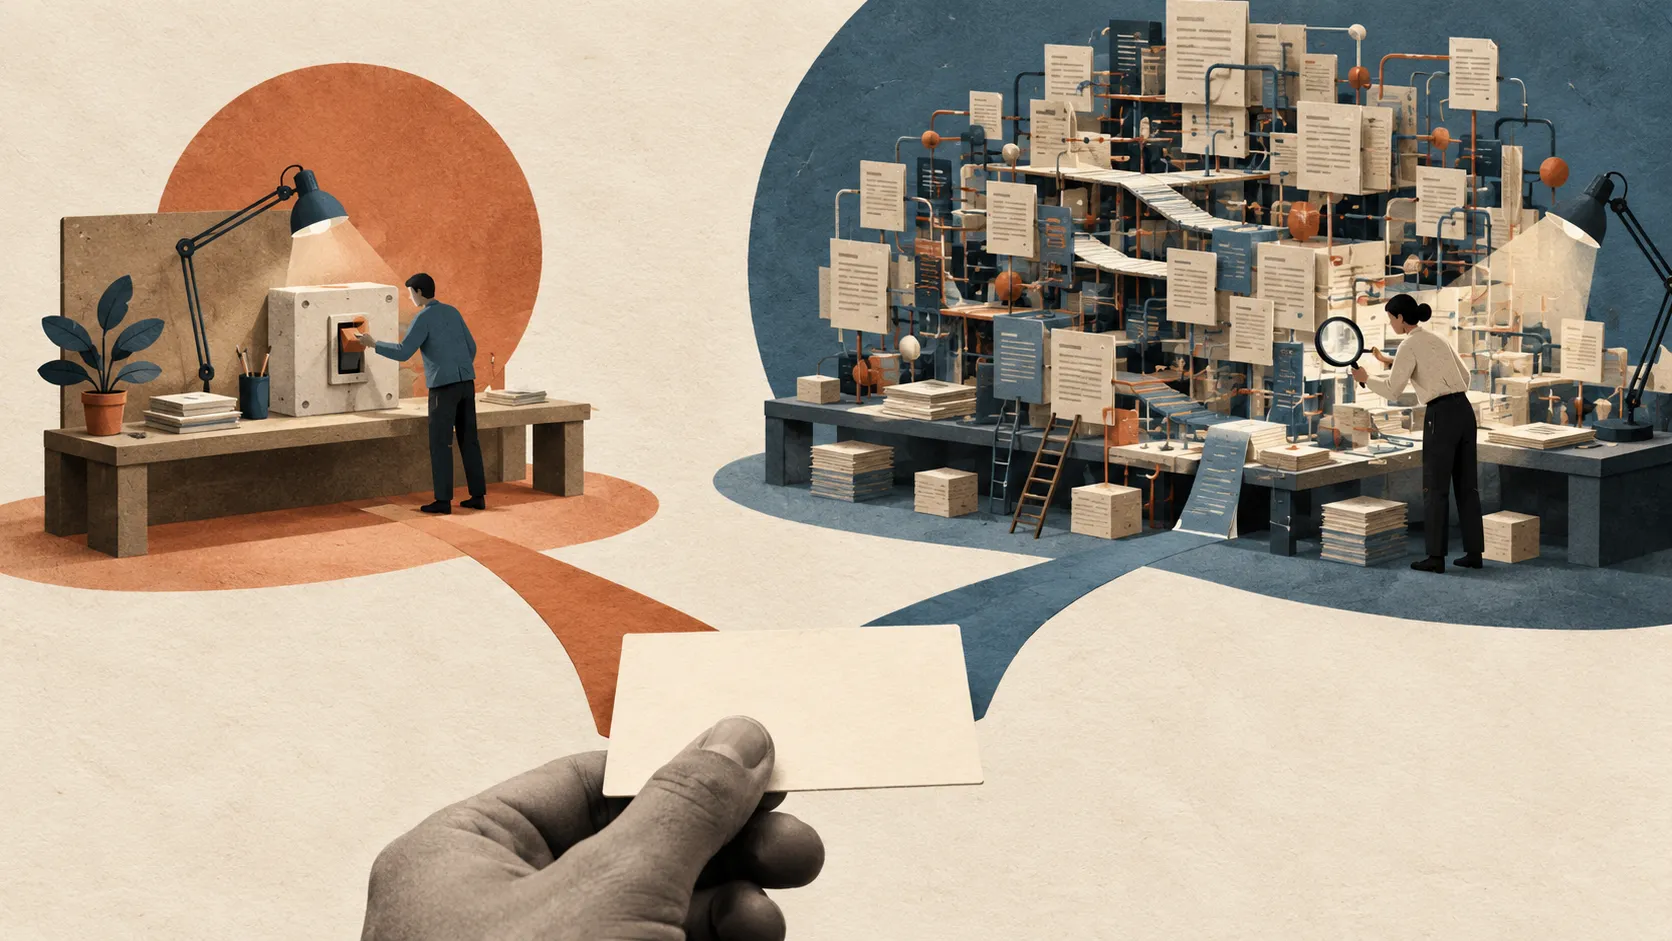
در یک برنامه، تغییر زبان رابط کاربری فقط به ویرایش یک خط تنظیمات نیاز دارد. در برنامهای دیگر باید هزاران متن پیدا شوند، سامانهٔ ترجمه اضافه شود، چیدمان صفحهها تغییر کند و همهچیز دوباره بررسی شود. اگر منظور زبان برنامهنویسی باشد، شاید با یک مهاجرت کامل روبهرو باشیم.
یک خط یا سه هزار خط: یک درخواست کوتاه میتواند پشت خود کارهای بسیار متفاوتی داشته باشد. اینها مثالهای فرضیاند و تعداد خطوط هم معیار دشواری نیست. نکته این است که خودِ درخواست، نیاز واقعی پروژه را روشن نمیکند.
بهنظر من مرز کاربرد مدلهای تصمیمگیری کمهزینه همینجاست. Jev و Laya میتوانند هزینهٔ قضاوتهای کوچک در نرمافزار را کاهش دهند. اما انتخاب مدل مناسب Claude برای یک کار برنامهنویسی، شناخت بیشتری از کاری میخواهد که باید انجام شود.
تصمیمهای کوچک، فرصت واقعی برای کاهش هزینه
Jev از روی اطلاعاتی که دریافت میکند، گزینه، امتیاز یا احتمال پاسخ مثبت برمیگرداند. مستندات آن پیشنهاد میکنند پرسشها مشخص و محدود باشند و پاسخها در کد ترکیب شوند. Laya نیز تصمیمهای ساختاریافتهٔ مشابهی ارائه میکند. معرفی Jev، معرفی Laya
فرض کنید سامانهٔ پشتیبانی بارها از یک مدل گران میپرسد آیا پیام دربارهٔ صورتحساب است یا مشتری ناراضی بهنظر میرسد. یک لایهٔ تصمیمگیری ارزانتر میتواند برای این پرسشها مناسب باشد، بهشرط اینکه دقت آن با پیامهای واقعی سنجیده شود.
| تصمیم | اطلاعات لازم | فرصت کاهش هزینه |
|---|---|---|
| تشخیص نیت یا احساس | پیام و بخش مرتبط گفتوگوی قبلی | حذف یک فراخوانی طبقهبندی گرانتر |
| تشخیص نیاز به اسناد داخلی | درخواست و توضیح منابع موجود | جلوگیری از بازیابی غیرضروری |
| انتخاب ابزار شناختهشده | درخواست، ابزارهای نامزد و شناسههای لازم | کاهش کار انتخاب ابزار |
| پالایش متنهای بازیابیشده | پرسش و متنهای پیداشده | کاهش ورودی مدل پاسخدهنده |
| انتخاب مدل اجرا | شواهد مربوط به کار و نتایج اندازهگیریشدهٔ مدلها | استفاده از مدل گران در موارد مناسب |
اینها کاربردهای پیشنهادی برای ارزیابیاند، نه وعدهٔ عملکرد. RAG یعنی بازیابی اطلاعات مرتبط پیش از پاسخدادن. یک درخواست میتواند هم سند بخواهد و هم ابزار زنده: «سفارش من را بررسی کن و سیاست بازگشت کالا را توضیح بده».
TypeSafe نمونههایی از پالایش متن برای RAG و انتخاب تابع با آرگومانهای برگرفته از فهرستهای بسته منتشر کرده است. پالایش RAG، انتخاب تابع
پس از انتخاب تابع، اعتبارسنجی دادهها، کنترل مجوزها، اجرا و مدیریت خطا همچنان بر عهدهٔ برنامه است. نوشتن یک پرسوجوی آزاد یا اجرای مهاجرت به مراحل دیگری نیاز دارد.
فهم درخواست، دشواری اجرا را مشخص نمیکند
یک طبقهبند ممکن است درست تشخیص دهد که تغییر زبان، کاری نرمافزاری است. برای انتخاب مدل Claude، شاید لازم باشد مخزن بررسی شود: ترجمههای موجود، وابستگیها، آزمونها، شرایط استقرار و تصمیمهای قبلی.
«احراز هویت را درست کن» هم همین وضعیت را دارد. شاید یک تنظیم جا افتاده باشد؛ شاید مشکل به نشستها، مجوزها و ذخیرهسازی مربوط شود. بدون بررسی، برآورد دشواری بر اطلاعات ناقص تکیه دارد.
اطلاعات در حین کار نیز تغییر میکند. یک آزمون ناموفق وابستگی دیگری را آشکار میکند. ابزار نتیجهای غیرمنتظره میدهد. تغییری که محلی بهنظر میرسید بر سرویس دیگری اثر میگذارد. مسیریابی بر اساس جملهٔ نخست، نمیتواند یافتههای بعدی را از پیش بداند.
این مدلها زمینه میخوانند؛ مسئله، زمینهٔ درست است
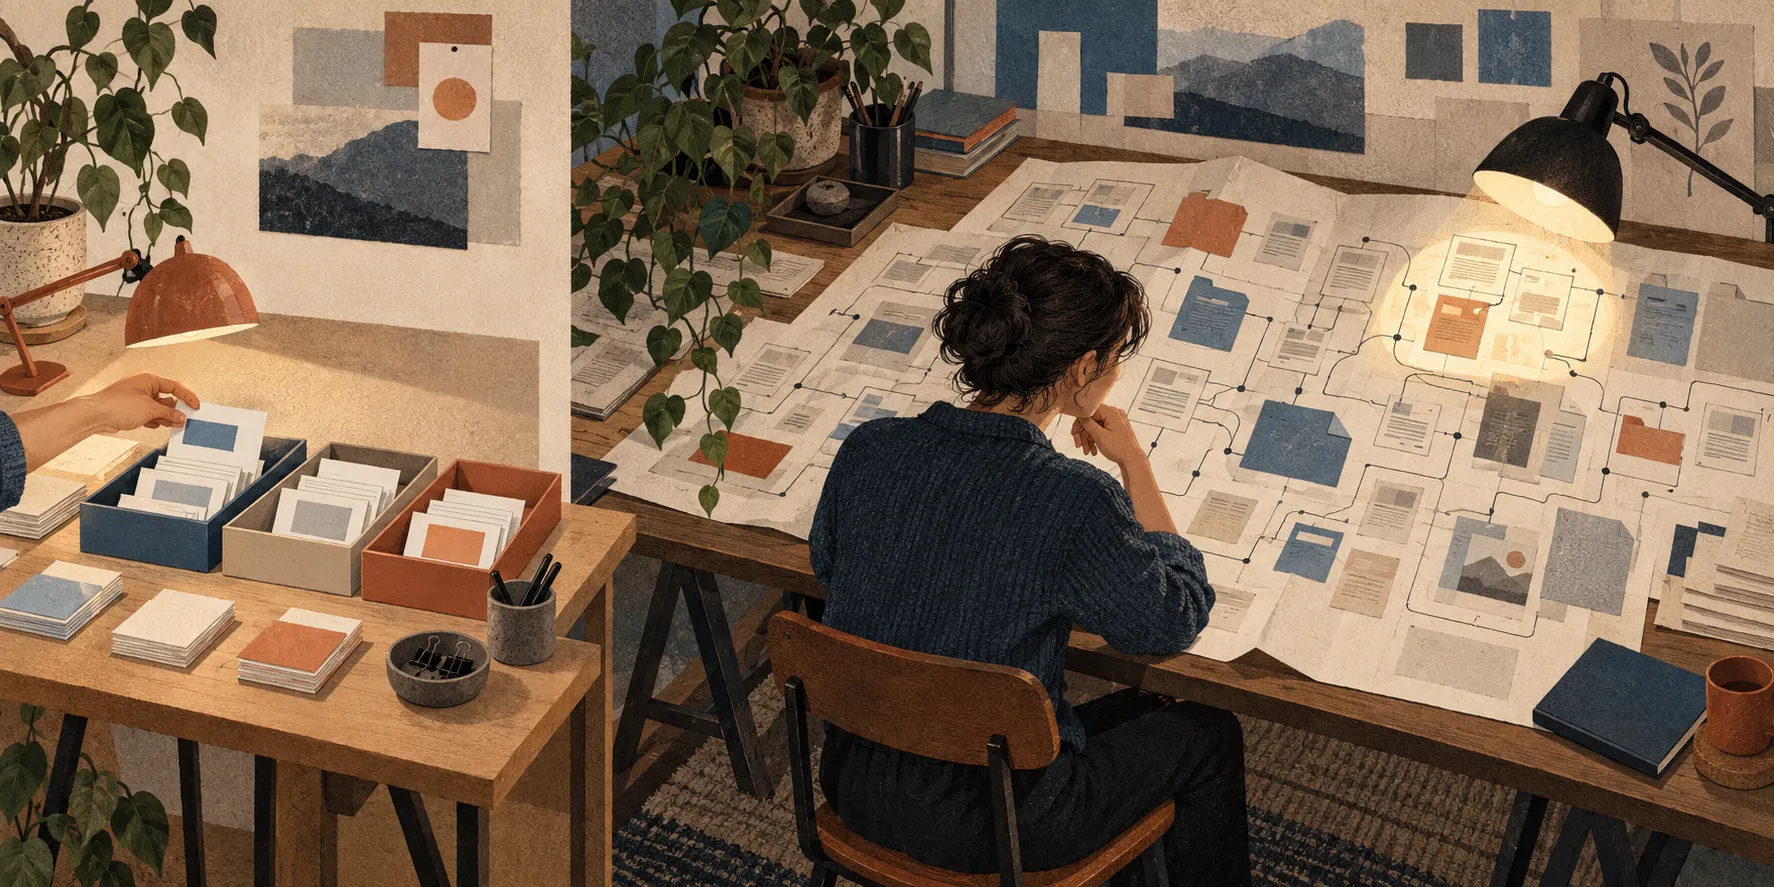
اینکه بگوییم Jev و Laya زمینه نمیپذیرند دقیق نیست. Jev 1.13 سقف ۶۴ هزار توکن برای درخواست دارد؛ مجموع وضعیت و طولانیترین پرسش نیز نباید از ۳۲ هزار بگذرد. Laya انگلیسی بهصورت پیشفرض ۵۱۲ توکن دارد؛ نسخهٔ چندزبانه ۱۰۲۴ و قابلیت افزایش تا ۸۱۹۲. محدودیتهای Jev، محدودیتهای Laya
جا شدن متن، تضمین فهم آن نیست. TypeSafe دشواری در استدلال چندمرحلهای و اثر منفی جزئیات نامرتبط را گزارش میکند. Laya نیز خطاهای با اطمینان بالا را مستند کرده و ارزیابی احتمالها روی دادههای خودتان را توصیه میکند. محدودیتهای Jev، محدودیتهای Laya
«همین کار را برای حساب دیگر انجام بده» به گذشته وابسته است. باید عملیات، حساب و نتیجهٔ تلاش قبلی معلوم باشند. خلاصه میتواند این اطلاعات را حفظ کند، اما ممکن است آنها را حذف کند یا قدیمی شود. ساخت و نگهداری این وضعیت هم هزینه دارد.
مسئولیت محدود و بازبینی بر اساس شواهد
پیشنهاد من استفاده از کد برای قواعد دقیق، مدل تصمیمگیری برای طبقهبندی معنایی و عامل برنامهنویسی برای بررسی و پیادهسازی است.
وقتی دشواری به جزئیات مخزن وابسته است، ابتدا بررسی کنید. سپس با یافتهها مدل را انتخاب کنید، مسیر مشخصی برای موارد نامطمئن داشته باشید و با تغییر شواهد اجازهٔ ارتقا به مدل قویتر بدهید. آستانهٔ اطمینان باید از خطاهای مشاهدهشده بهدست بیاید؛ کمبود زمینه و درخواست ناآشنا بررسی جداگانه میخواهند.
این طراحی میتواند به مسیریابی در جریان کاری Claude کمک کند، اما بهتنهایی Jev یا Laya را به مسیریاب عمومی قابلاعتماد تبدیل نمیکند. کاربرد آن به شواهد ورودی و تصمیمهایی بستگی دارد که واقعاً ارزیابی شدهاند.
هزینه را برای کار تمامشده حساب کنیم
فرض کنید طبقهبندی فعلی ۰٫۰۰۲ دلار هزینه دارد. جایگزین ۰٫۰۰۰۰۲ دلار است، اما ۲۰ درصد درخواستها هنوز به فراخوانی قبلی نیاز دارند. میانگین به ۰٫۰۰۰۴۲ دلار میرسد: ۷۹ درصد صرفهجویی در آن مرحله، پیش از هزینهٔ خطا. این اعداد فرضیاند، نه تعرفه یا نتیجهٔ آزمایش.
اگر طبقهبندی فقط ۵ درصد صورتحساب باشد، صرفهجویی کل با ثابتماندن بقیهٔ کار حدود ۳٫۹۵ درصد است. کاهش بیشتر هزینه نیازمند حذف کار گران بعدی یا کوچککردن ورودی آن است.
در زمان انتشار، قیمت اعلامشدهٔ Jev برای هر میلیون توکن ورودی ۰٫۰۴۲ دلار است و خروجی هزینه ندارد. میزبانی شخصی Laya هم هزینهٔ پردازش و نگهداری دارد. قیمت Jev
معیار مفید، هزینهٔ هر کار درست انجامشده است؛ با احتساب بررسی، تلاش دوباره و تغییر مدل. یک تصمیم ارزانِ اشتباه میتواند بازیابی گرانی در پی داشته باشد.
من از نیت، احساس، ارتباط اسناد و فرایندهای شناختهشده شروع میکنم. در عامل برنامهنویسی، انتخاب مدل باید با شناخت تازه از پروژه قابل بازبینی بماند. یک درخواست کوتاه ممکن است به یک خط یا مهاجرتی بزرگ برسد. سامانه پیش از تعهد به اجرا باید شواهد کافی برای شناخت کار داشته باشد.